

AI予測の精度を上げたら打ち手は変わるのか? Anaplanでアルゴリズムを変えて最適化まで回してみた【Animeplan第三弾】
前回、架空のアニメ実績データで作った予測モデル「Animeplan」に Anaplan Optimizerを増設して、販促の打ち方まで決めさせた話を書きました。
Anaplan Forecasterを使った前回の記事の最後に、宿題を1つ残していました。
アルゴリズムを変えたら、最適化の結果はどう変わるのか
今回はそこを確かめます。
アルゴリズムを一通り差し替えて予測を出し直し、同じ制約のまま最適化までかけ直しました。
先に結論を言うと、想定外の結果になりました。
予測の見た目はほとんど変わらなかったのに、出てきた販促計画は変わったのです。
※本記事で扱うデータはすべてサンプルであり、実在の作品・実績とは一切関係ありません。
目次
1. AnaplanのAI予測手法を変えたら「平坦な予測」は直るのか
1作目で1つ引っかかっていたことがありました。
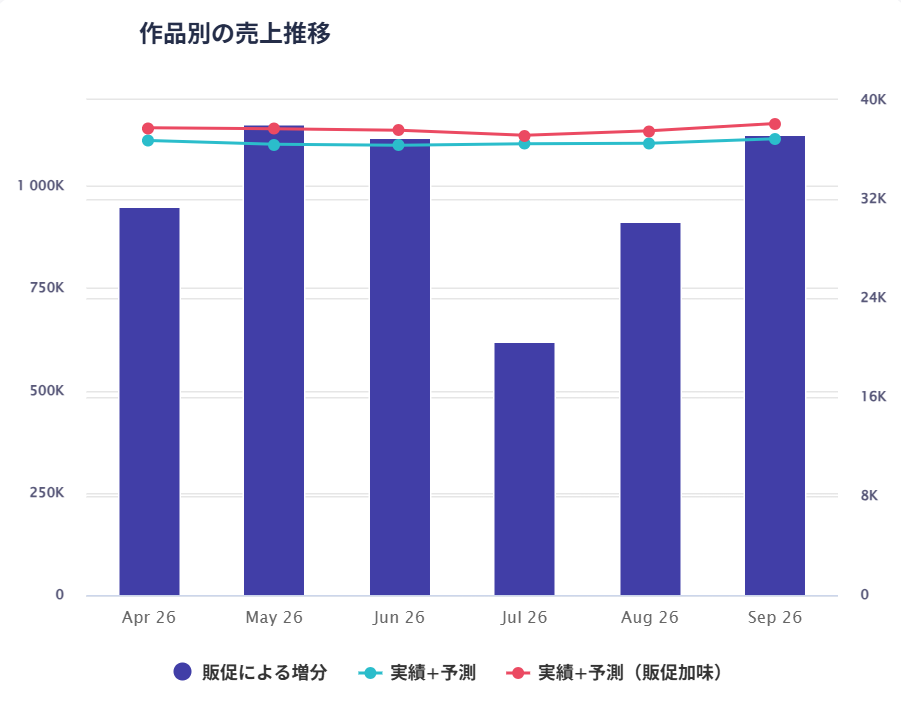
明らかに跳ねるはずのところが、予測では平坦に出ていたのです(下図の赤枠)。
あのときは「別のアルゴリズムを選べば違う結果になるのだろう」と書いて、そのままにしていました。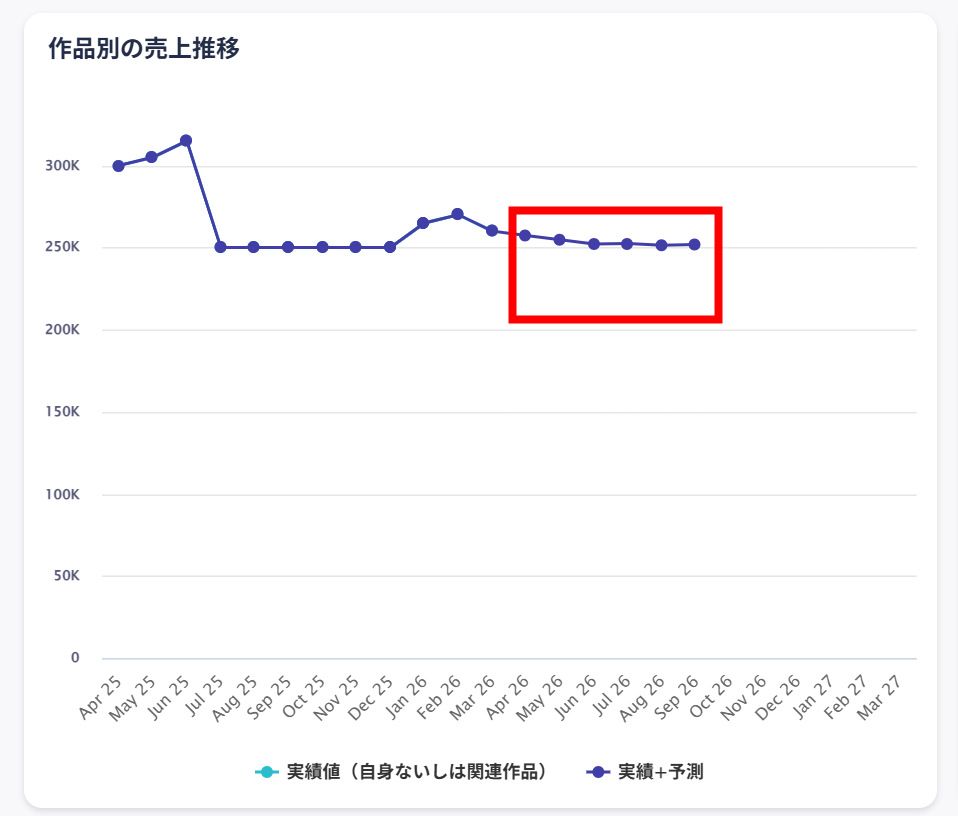
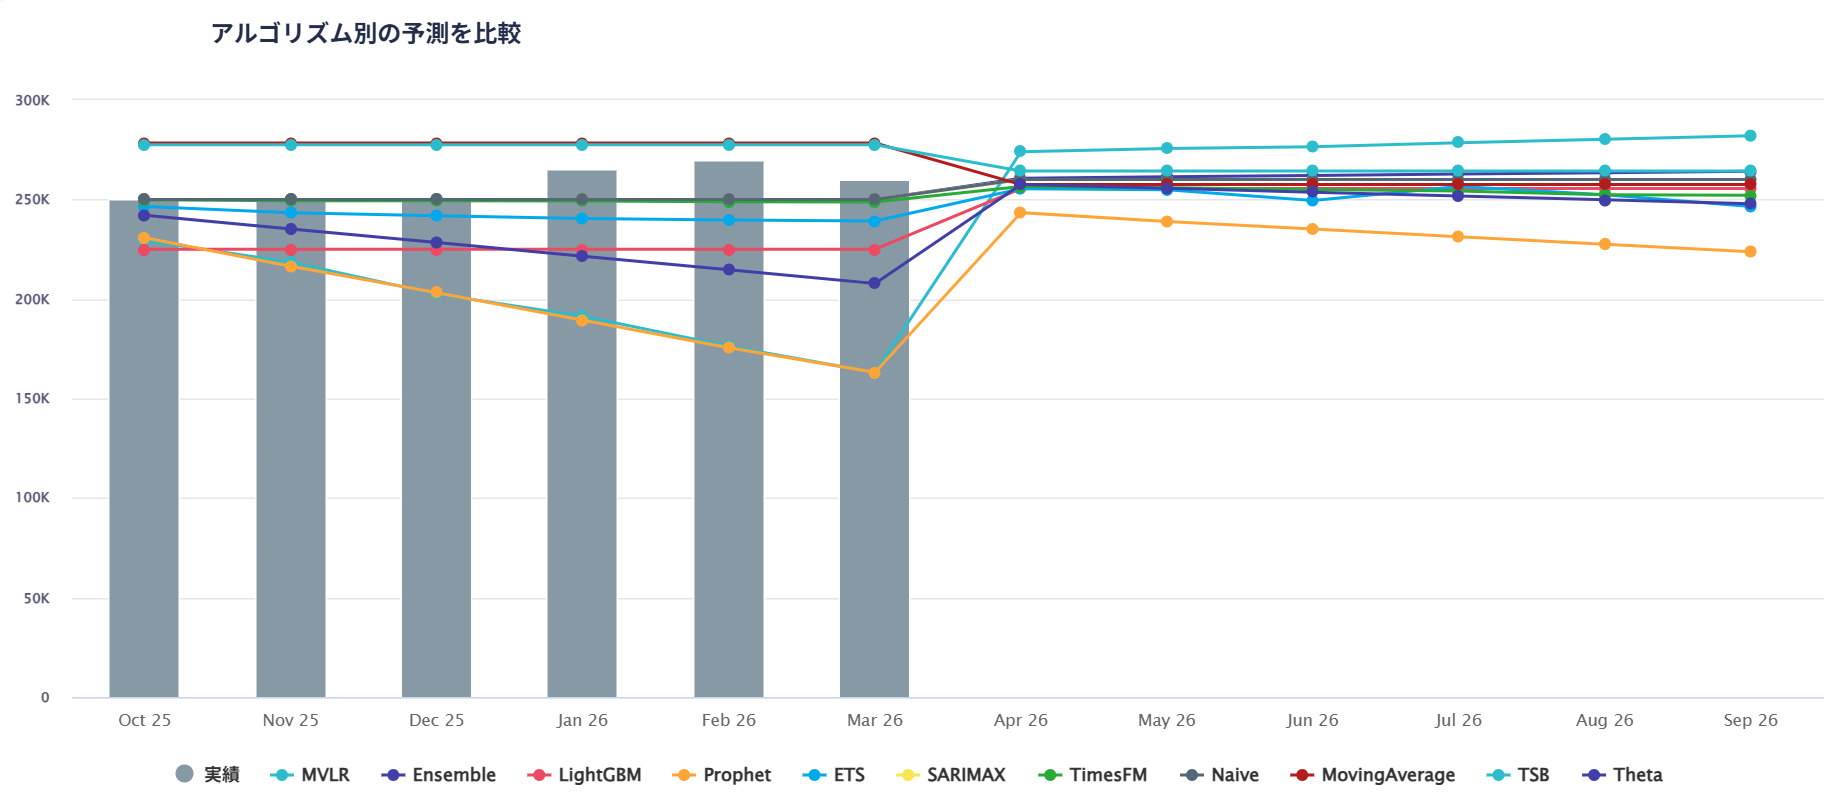
今回、Anaplan Forecasterが持つアルゴリズムをいくつか試しました。
使ったのは MVLR、Ensemble、LightGBM、Prophet、ETS、SARIMAX、TimesFM、Naive、Moving Average(移動平均)、TSB、Thetaです。
移動平均のような古典的な手法から、統計モデル、機械学習、時系列の基盤モデルまで、系統としてはかなり幅があります。
結果はどうだったか。
どの手法でも、あの箇所は平坦なままでした。
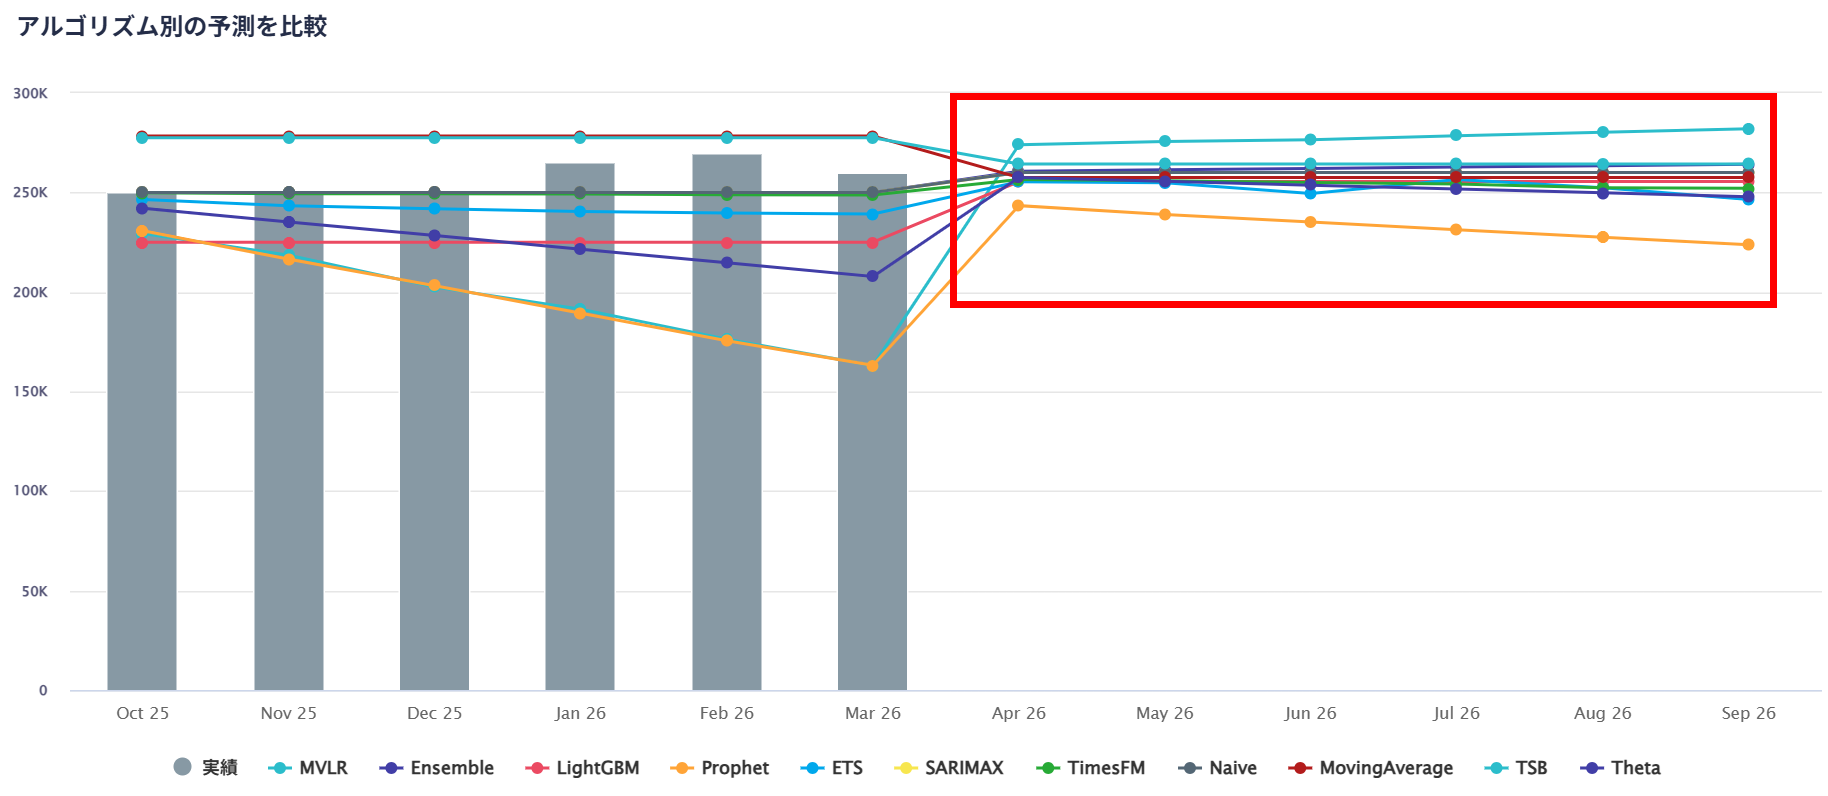
拍子抜けするような結果ですが、考えてみれば当然でもあります。
今回インプットにしているのは過去1年分の売上実績金額だけです。
「なぜここで跳ねるのか」を説明する情報が、そもそもデータに入っていません。
入っていない情報は、どんなアルゴリズムを使っても出てきません。
アルゴリズムの選択で解決するのは「データに入っている情報の読み取り方」であって、「データに入っていない情報」ではない。
当たり前のことなのですが、手を動かして目の前で並べられると、納得の質が変わります。
ここが直らないなら、次に投資すべきはアルゴリズムではなく説明変数のほうだ、という判断ができるようになります。
2. 予測値がほぼ同じでも、Optimizerの販促案が変わった理由
では、何も変わらなかったのか。そうではありませんでした。
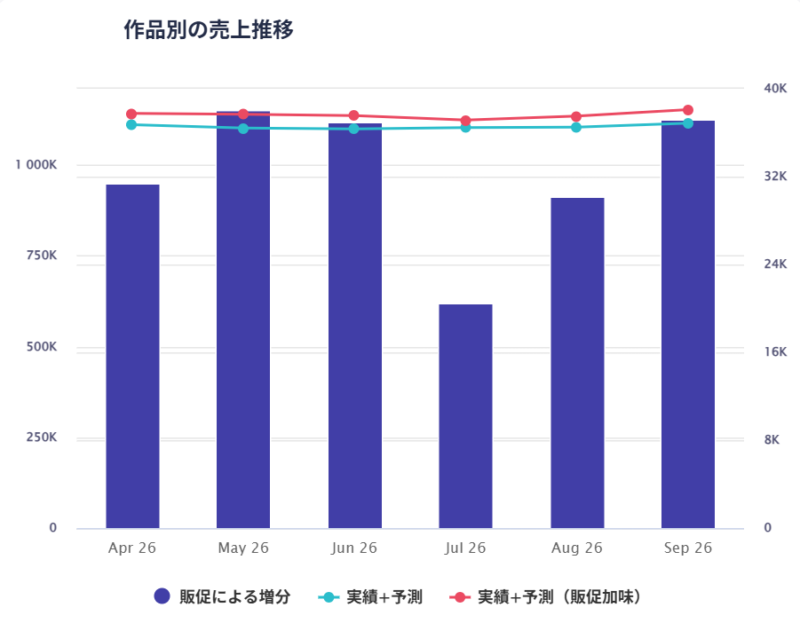
同じ制約条件のまま最適化をかけ直したところ、販促の配分は変わりました。
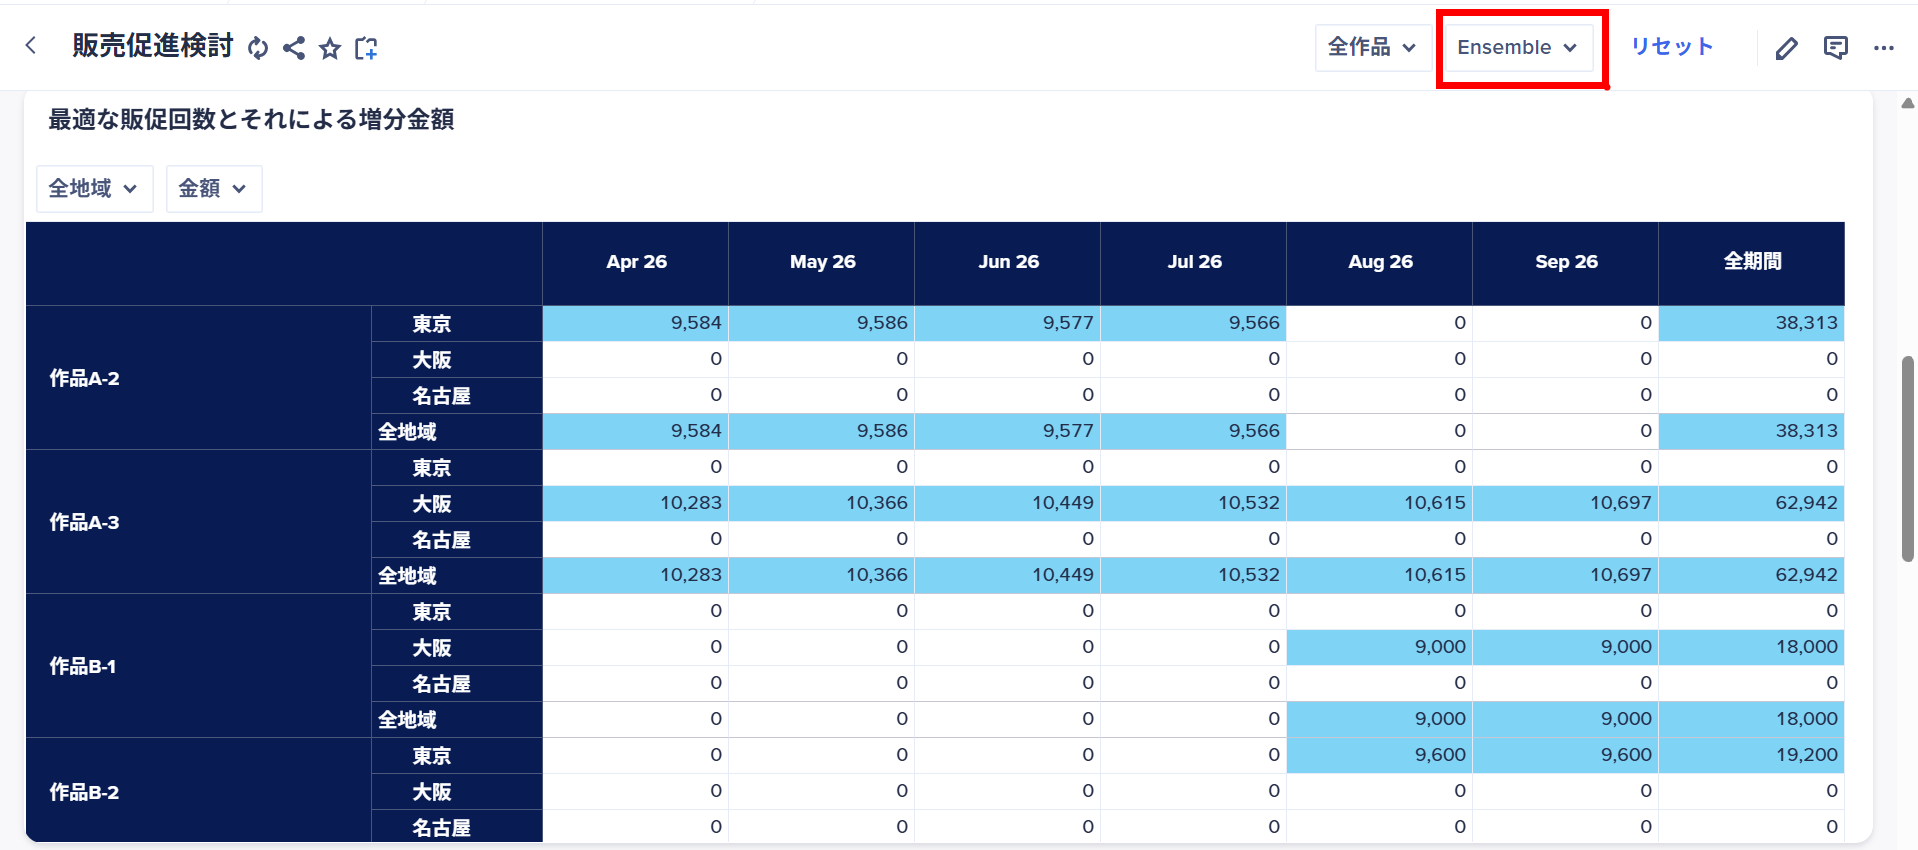
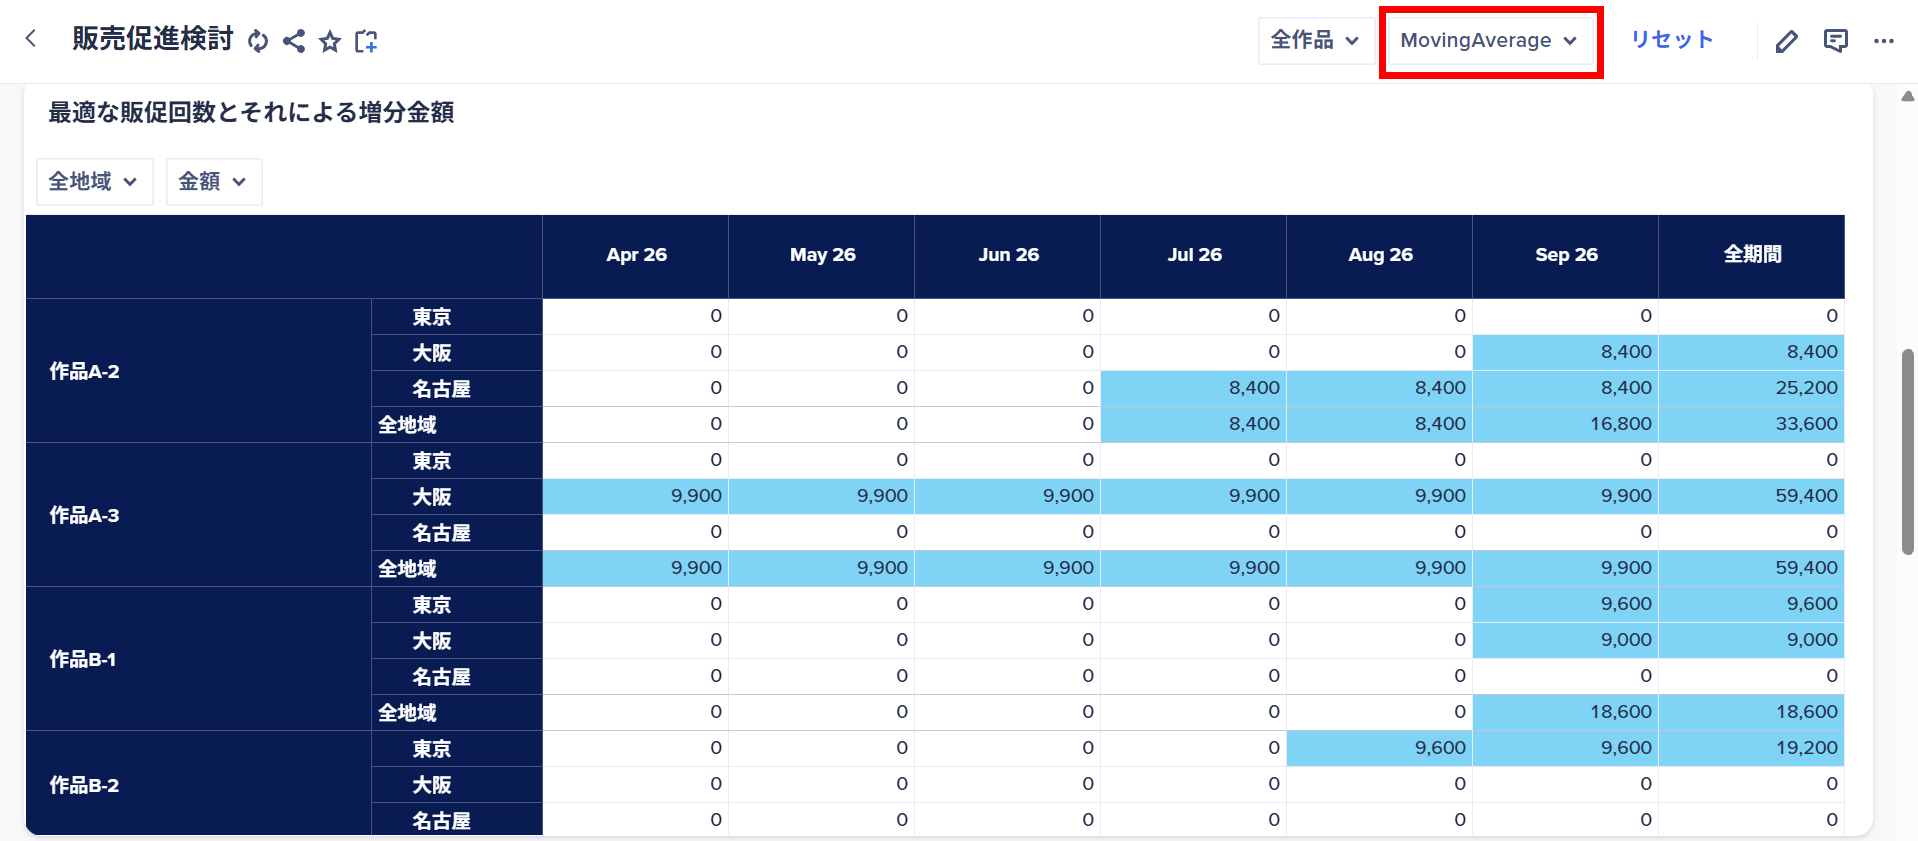
変わり方は一様ではありません。
- ある地域にまとめて寄っていた配分が、別の地域にごっそり移る
- 地域と作品の組み合わせは同じまま、打つ月だけがずれる
- 一部の組み合わせだけが入れ替わる
予測のグラフを重ねて見ると、線の形はどれも似ています。
にもかかわらず、そこから導かれる打ち手は別物になりました。
理由はシンプルです。
最適化は「どこが一番効くか」で配分を決めます。
そのため、候補が僅差で並んでいる場合、ほんのわずかな予測値の差でも順位はあっさり入れ替わります。
また、もう1つ確認できたことがあります。
配分は変わっても、合計の売上見込みはそれほど動かないということです。
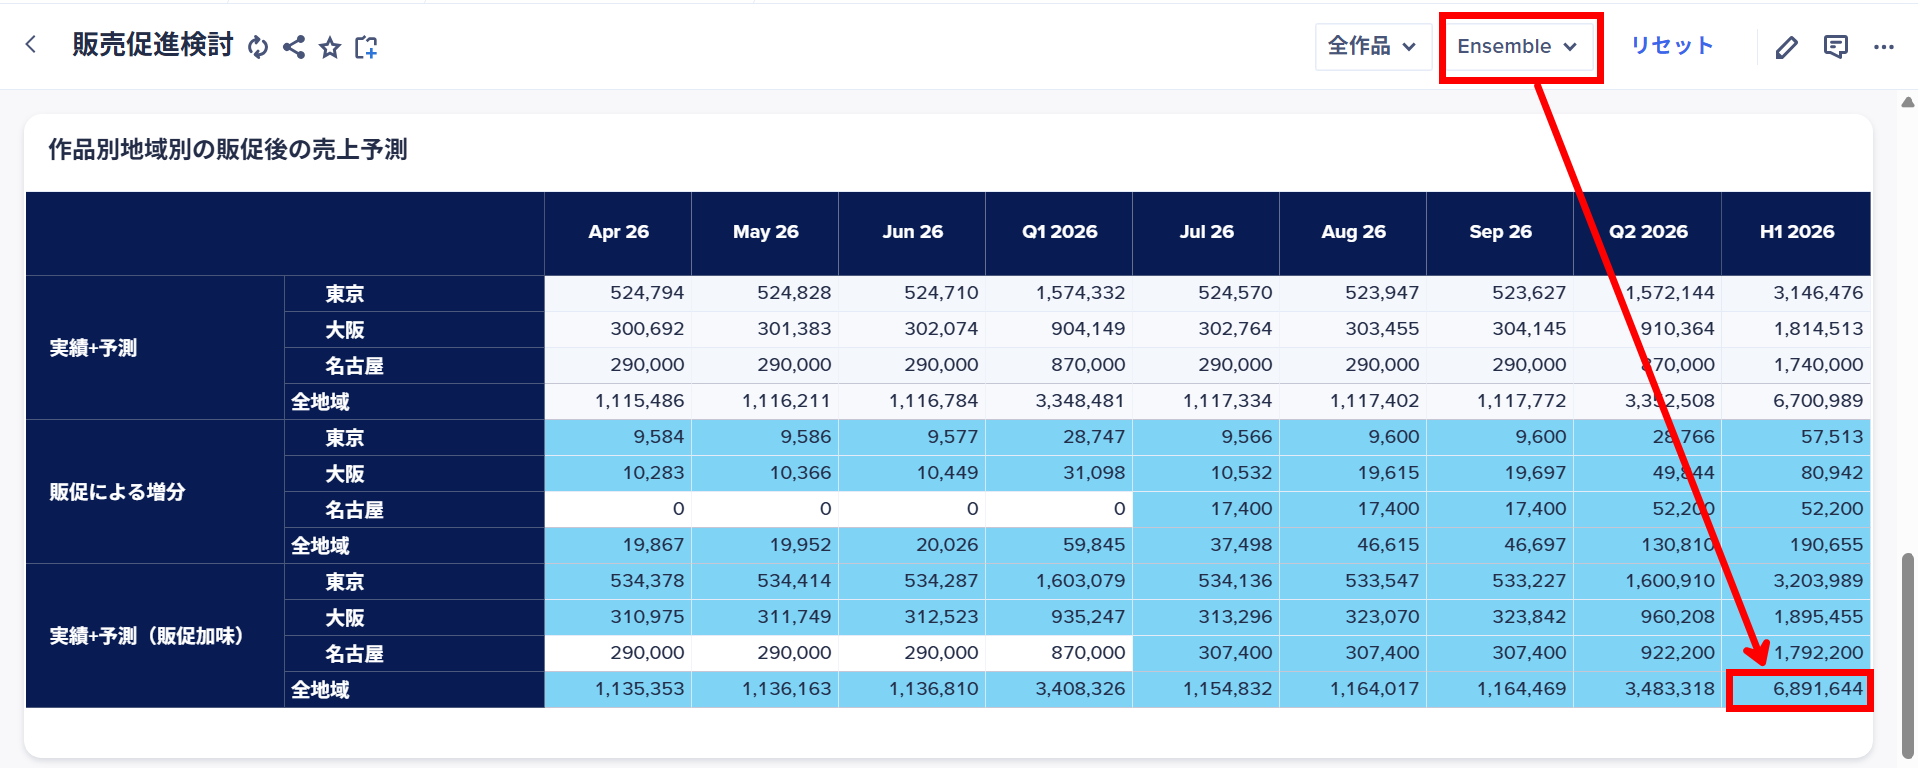
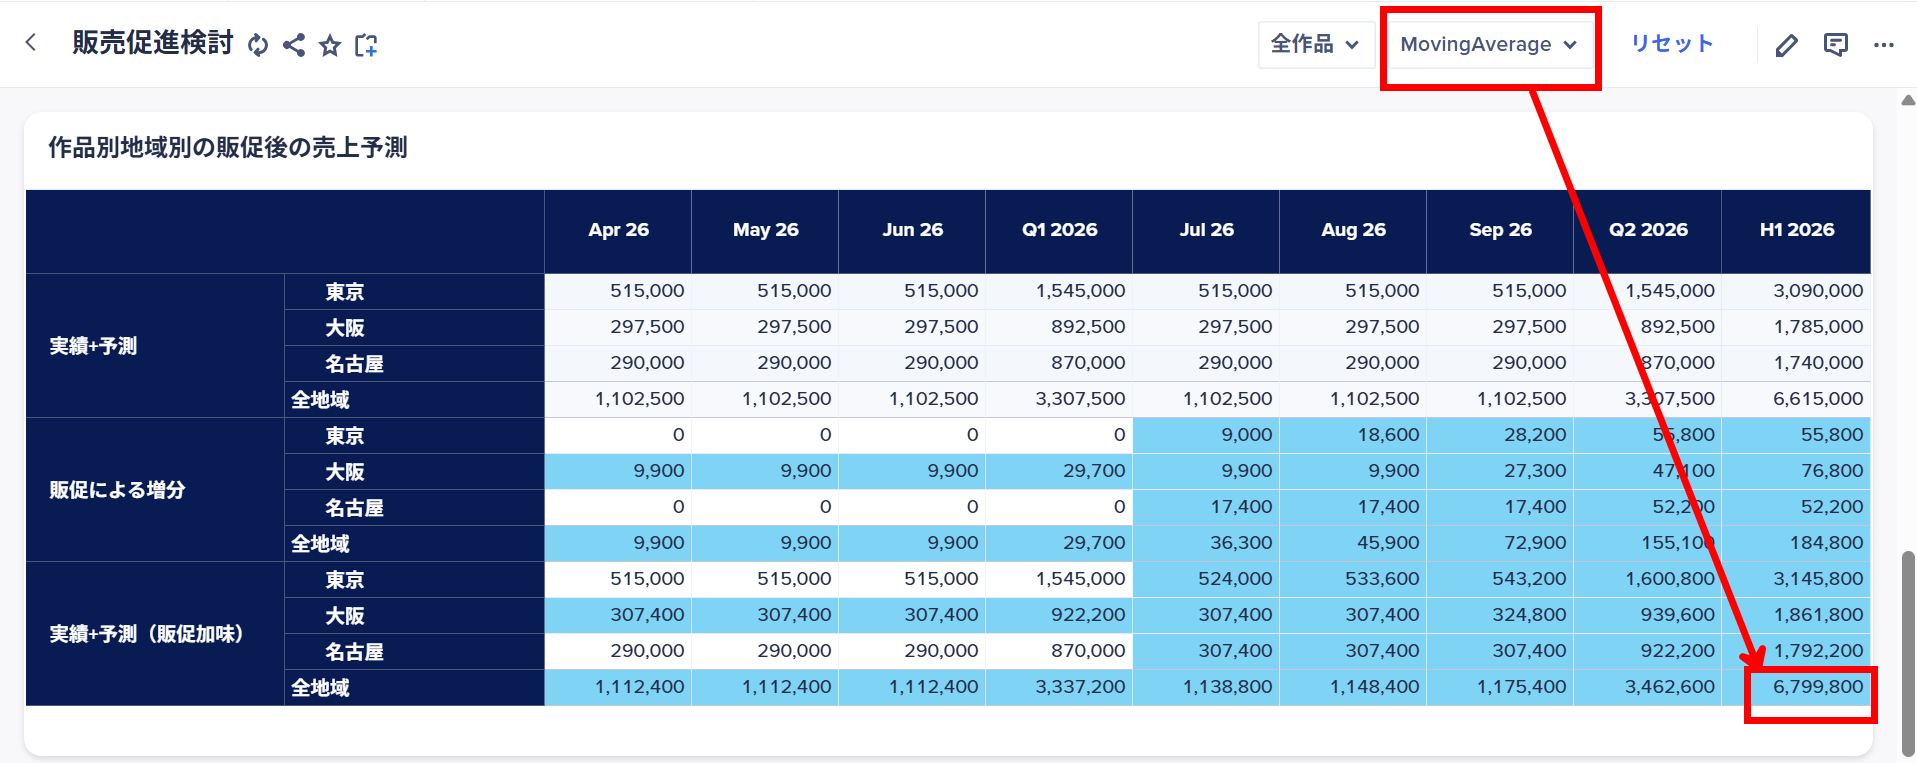
つまり、
中身の違う案が、ほぼ同じ成績で、複数存在している。
という状態です。
3. 「どれを選んでも同じ」なら、最適化する意味はあるのか
ここまで読んで、こう思った方もいるかもしれません。
「成績が変わらないなら、わざわざ最適化しなくてもいいのでは?」
もっともな疑問だと思います。
ただ、実際に結果を並べてみて、価値は別のところに2つあると感じました。
1. 出てきた案が、制約を全部満たしている
前回書いたとおり、現場で起きているのは「最適化に失敗している」のではなく「最適化を試みる余力がない」という状態です。
地域単位の上限、作品単位の上限、同一月の重複禁止、対象外の組み合わせ。
これらを全部満たす案を1つ作るだけで、Excelでの手作業は限界を迎えます。
「そこそこ良い案」であることより先に、「条件を1つも破っていない案」であることのほうが、実務では効きます。
会議に持ち込んだ案が制約違反で差し戻される、という手戻りがなくなるからです。
2. 同じくらいの成績の案を複数出せる
そして、今回の結果でむしろ価値が上がったのがこちらです。
成績がほぼ同じ案が複数あるということは、そこから先は数字以外の理由で選んでいいということです。
この地域は今期の人員が薄いから避けたい、この配分なら現場に説明しやすい、といった事情です。
そうした事情は、そもそも制約として書き切れないものが多くあります。
1案しか作れない状態では、そもそもこの議論すら始まりません。
「これしか案がないので、これで」になります。
同点の候補がいくつか並んで初めて、現場の判断が入る余地が生まれます。
最適化は、決定する装置ではなく、選択肢を用意する装置だと捉えるほうが実態に近いと感じました。
前回「出てきた配分について、なぜこうなったかを担当者が自分の言葉で説明できることが必要」と書きました。
今回の結果は、その一歩先の話です。
説明できるだけでなく、選べる状態にする。
ここまでいくと、最適化は現場から仕事を奪う道具ではなくなります。
4. どこまで精度を追うか:判断の3つの評価軸
1作目では「予測の置き場所」、2作目では「最適化を入れるべきか」を3つの軸で整理しました。今回は「精度をどこまで追い込むべきか」です。
精度は高いに越したことはありません。
ただ、精度改善には工数がかかるため、どこまでやるかを決める軸として、次の3つが使えると感じました。
1. その精度差は、打ち手を変えるか
一番重要な軸です。
予測の精度指標が改善しても、そこから決まるアクションが同じなら、業務上の価値は生まれていません。
逆に今回のように、わずかな差で配分が入れ替わるなら、精度は「見栄え」ではなく「意思決定の分岐点」として効いていることになります。
精度改善に投資する前に、一度打ち手まで通して確かめる価値があります。
2. 変わった打ち手を、実行できるか
配分が入れ替わったとして、それを実行に移せるかは別の話です。
月をまたいだ組み替えができない、地域間で予算を動かせない、といった制約が現実にはあります。
実行できない粒度で精度を上げても、成果にはつながりません。
精度を追う前に、自社がどの粒度まで打ち手を動かせるのかを確認しておくと、無駄な作り込みを避けられます。
3. 精度を上げる余地が、そもそもデータ側にあるか
今回の平坦な箇所がまさにこれでした。
アルゴリズムをいくら変えても直らないということは、伸びしろがアルゴリズム側ではなくデータ側にあるということです。
ここを取り違えると、手法の比較検討に時間を使い続けることになります。
手法を一通り試してみて改善しないなら、それは「説明変数を足すべき」というサインです。
判断材料としては、むしろ分かりやすい結果でした。
5. 検証そのものは、思ったより軽い
最後に、作業面の話を少しだけ。
今回の検証で手を加えたのは、比較用にアルゴリズムを複数用意した部分だけです。
モデルの構造には触れていません。予測を差し替えれば、そのまま最適化まで一通り回りました。
1作目で「予測のためにデータを外に出さなくていい」と書き、2作目で「予測から最適化までワンストップで完結する」と書きました。
そのメリットが一番効いたのは、実はこの検証の場面でした。
ここで効いてくるのは、試行1回あたりのコストです。
1回試すのにデータの受け渡しが挟まる構成だと、11通りを回す前に「まあ、1つの手法でいいか」となります。
検証を前提にするなら、初期構築のしやすさより「何回試せる構成か」を評価軸に入れておくと後で効いてきます。
試行回数を稼げる構成かどうかは、最初の構築より、こういう検証のときに効いてきます。
まとめ:精度の追求より先に、選べる状態を作る
3回にわたって、架空のアニメ実績データで予測から打ち手までを組んできました。今回分かったことを整理します。
- アルゴリズムを変えても、データに入っていない動きは再現されない
- 一方で、わずかな予測の差でも、最適化が出す配分は入れ替わる
- ただし成績はほぼ横並びで、「同点の複数案」が存在する状態になる
- だからこそ、最適化の価値は唯一解を出すことではなく、制約を満たした選択肢を複数用意すること自体である
「AIが出した数字をそのまま使っていいのか」という不安は、多くの現場にあると思います。
今回の結果は、その不安に対する1つの答えでもあると思います。
唯一の正解として受け取るのではなく、条件を満たした候補として受け取る。
選ぶのは人のままでいい、ということです。
予測の精度をどこまで追うべきか判断がつかない、AIが出した計画をどう業務に組み込むか決めきれない。
そうしたことに心当たりがあれば、今回の3つの軸で一度確認してみてください。
FREEDIAでは、こうした小さな検証から一緒に始めるご相談も受けています。
今あるデータで何ができそうか、という段階からでもお気軽にお声がけください。
参考
この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。